
giq GPU Inference Queue · código abierto · Apache‑2.0
Gestión de inferencia on‑premises para GPU de workstation.
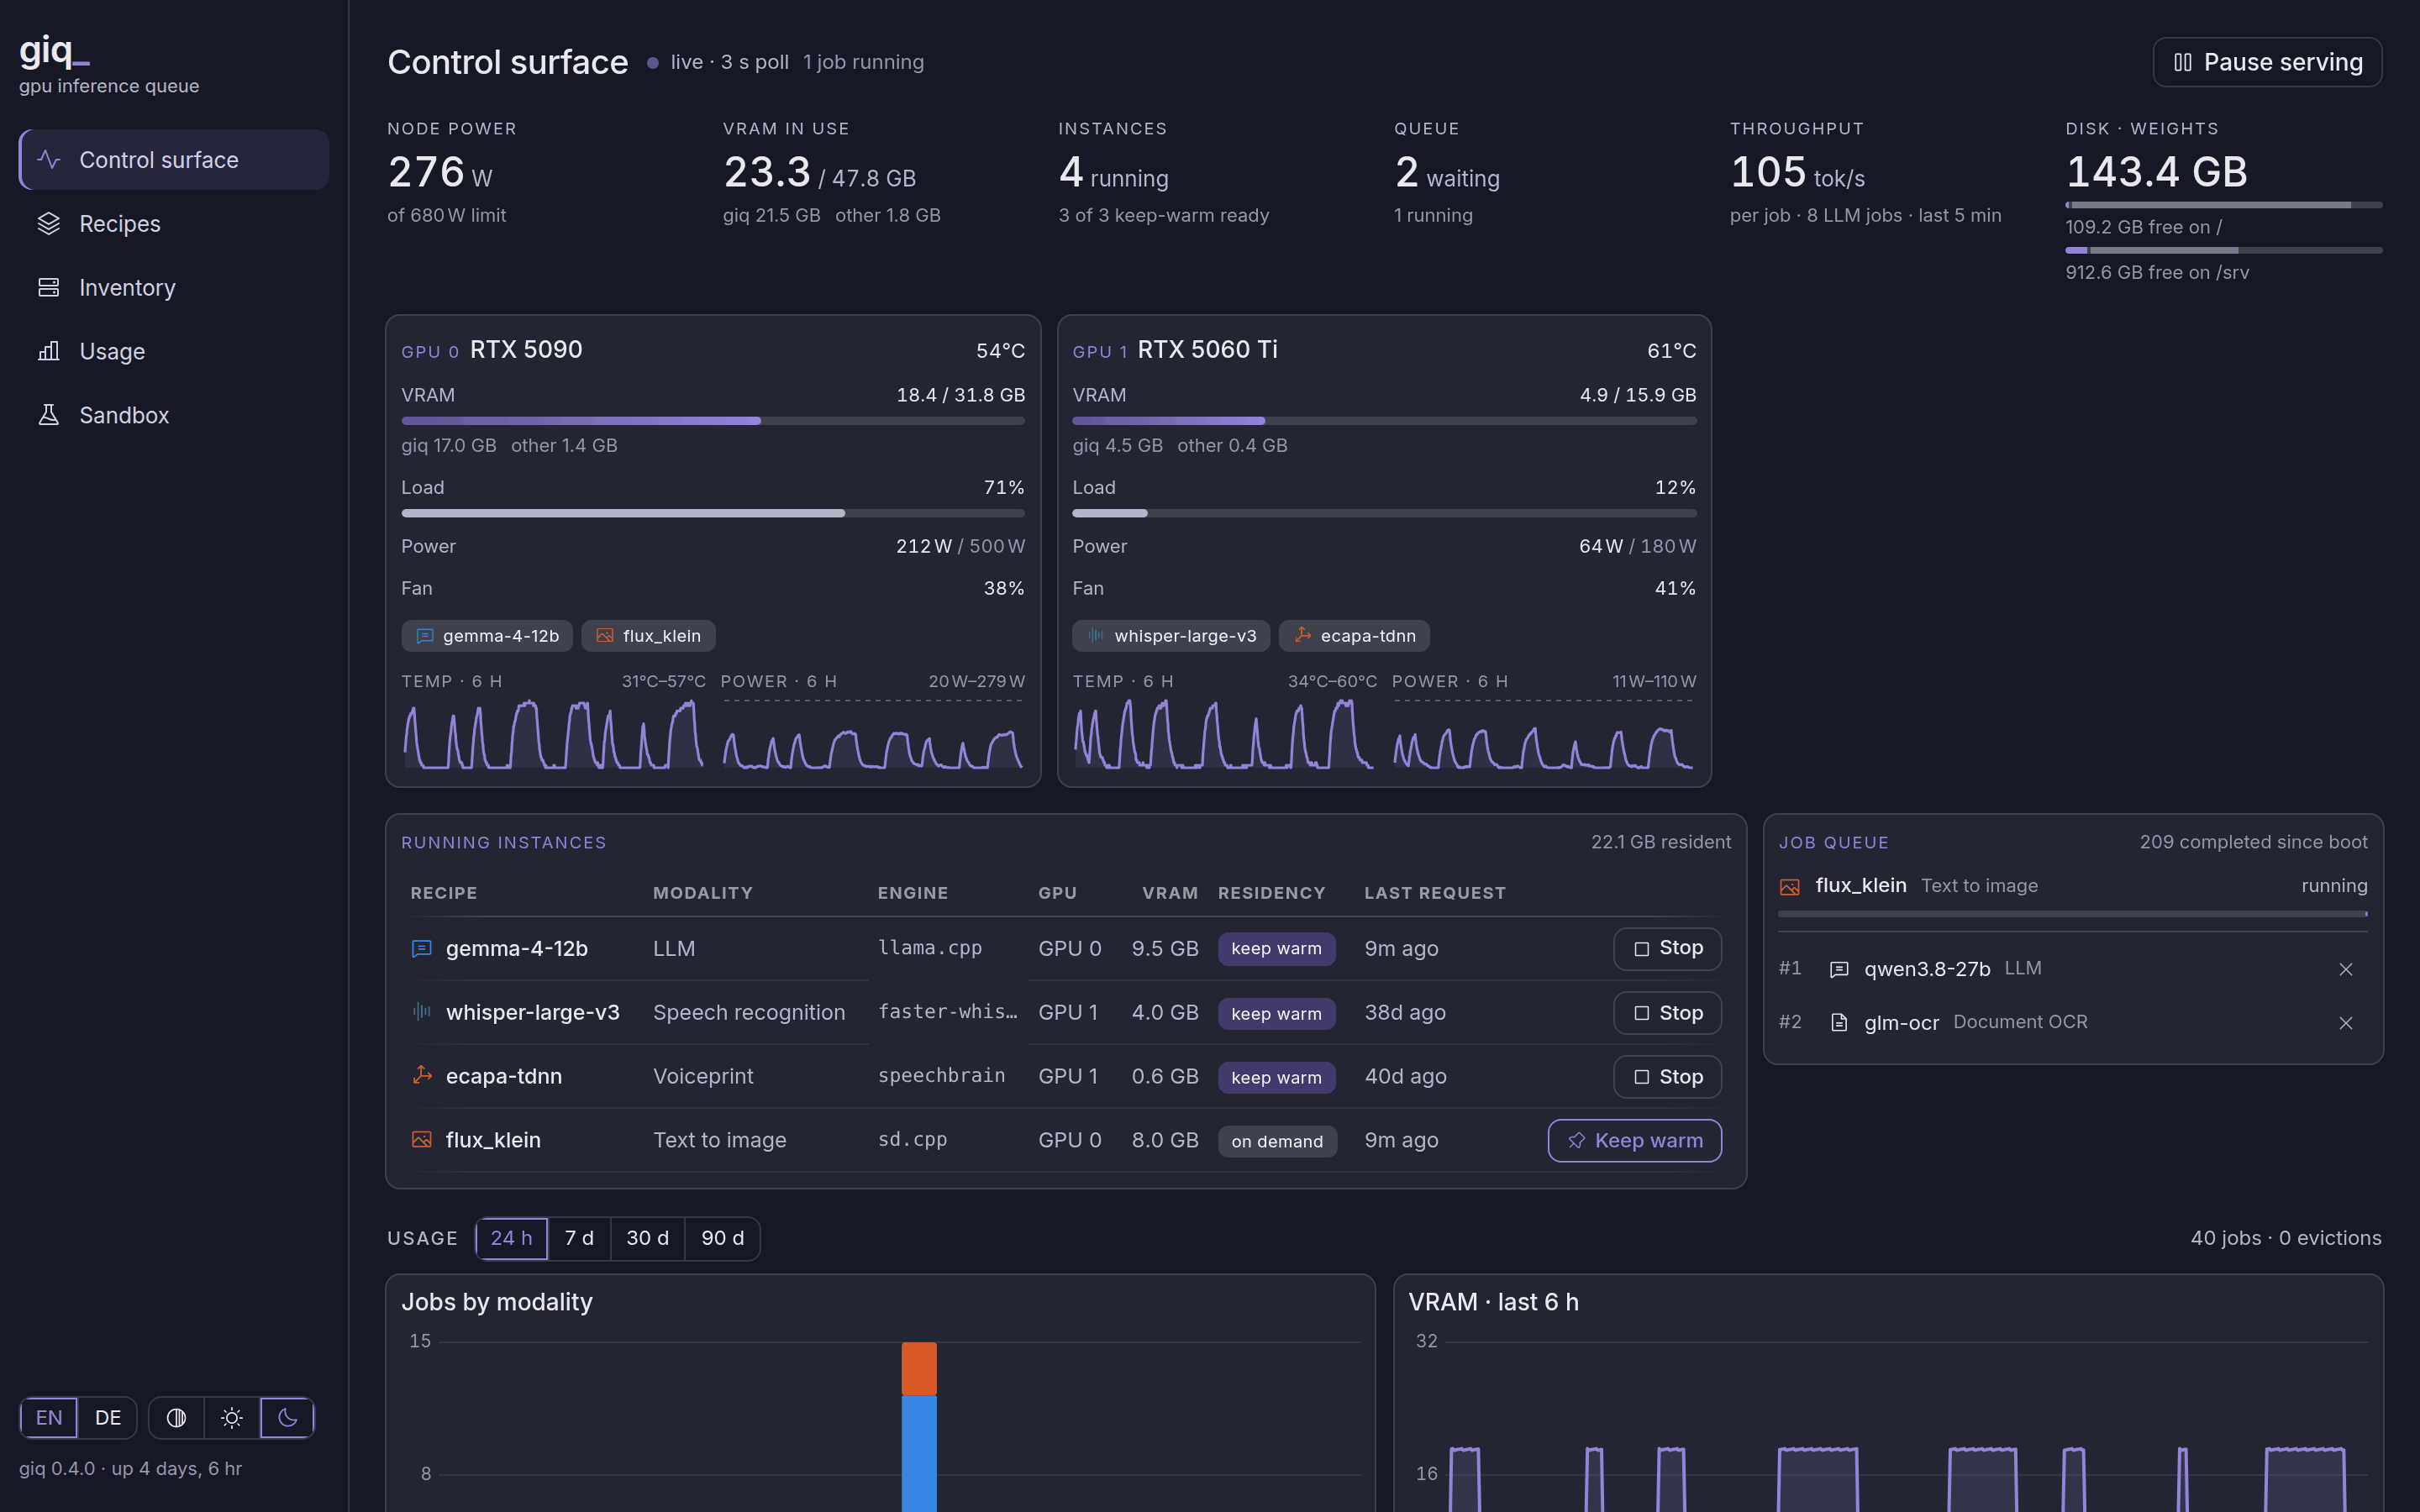
giq ejecuta los modelos de IA de todas sus aplicaciones en una o varias GPU locales: lenguaje, voz, imagen y más de serie, y sus propias modalidades mediante plugins. Decide qué tarjeta atiende qué, qué permanece cargado y qué espera.
Por qué lo creamos
La capa de inferencia para IA confidencial on‑premises
Queríamos ofrecer a nuestros clientes asistentes de IA para su trabajo de ingeniería: agentes que conocen sus documentos, herramientas y procesos. La mayoría de esos datos no pueden salir de la empresa, así que los asistentes se ejecutan en sus propias instalaciones, y la inferencia que hay debajo debe ser aislada y transparente.
Un servidor de inferencia dedicado es una gran inversión antes de saber si la IA ayuda. Las GPU de workstation son asequibles, pero una o dos no pueden alojar a la vez todos los modelos que necesita un asistente.
giq hace que esas tarjetas basten: decide qué tarjeta atiende qué, qué permanece cargado y qué espera, y admite más tarjetas a medida que crece el trabajo.
Arquitectura
Cómo encaja giq
Varias aplicaciones, una instancia de giq, una o varias GPU. Las aplicaciones hablan con una API; giq ejecuta cada petición en el modelo y la tarjeta adecuados, y no envía nada fuera de sus instalaciones.
Deslice lateralmente para ver el diagrama completo.
giq hoy
Qué hace giq
En uso desde febrero de 2026. De serie ofrece 10 modalidades, desde LLMs y visión hasta voz, OCR, estimación de profundidad y música, sobre llama.cpp, vLLM, stable‑diffusion.cpp y entornos de Python.
Ejecutar un solo modelo es sencillo; el trabajo de giq está en compartir la tarjeta: cifras de VRAM medidas en hardware real, cada motor en su propio proceso y el menor número posible de desalojos.
Una sola cola
Cada petición pasa por la misma cola de trabajos, así que dos clientes nunca cargan modelos al mismo tiempo.
Compatible con OpenAI
Endpoints de chat, Responses, transcripción y voz. A los clientes existentes solo les hace falta una nueva URL base.
Recetas
Un archivo YAML por modelo: pesos, motor, parámetros y una cifra de VRAM, medida o marcada como estimación.
Residencia por receta
Mantener cargado, bajo demanda o desactivado. Se puede cambiar en tiempo de ejecución y se conserva tras reinicios.
Varias GPU
Una receta puede vincularse a una tarjeta. Solo allí se comprueba, se carga y se desaloja.
Espacio para otros usuarios de la GPU
giq comparte la workstation. Cuando alguien necesita las GPU en exclusiva, una llamada pausa giq y libera todas las tarjetas.
Plugins
Sus propias modalidades
El trabajo de ingeniería trae sus propias cargas de GPU: Gaussian splatting, structure from motion, procesamiento de nubes de puntos y más.
Cada una puede convertirse en un plugin de giq: un paquete de Python con su motor, recetas, rutas de API y panel, que comparte la tarjeta con la misma cola, el mismo control de VRAM y el mismo desalojo que todo lo demás.
Los plugins pueden ser privados: giq tiene licencia Apache‑2.0, así que un plugin propietario puede funcionar sobre el núcleo abierto.
Privacidad
Cada trabajo registrado, ningún contenido guardado
giq registra qué trabajos se ejecutaron, en qué modelo y durante cuánto tiempo. Las peticiones, imágenes y resultados permanecen solo en memoria, y ninguna petición va a una API alojada.
Una prueba lo garantiza: envía una cadena marcadora por cada ruta de registro y falla si aparece en cualquier cosa que giq escriba.
# tests/test_privacy.py
CANARY = "zqx-private-prompt-canary-8f3a"
Código abierto
Desarrollado en abierto
La parte que ejecuta los modelos, decide qué se carga y ve cada petición debe poder inspeccionarse. Por eso giq es de código abierto, igual que los motores que ejecuta: llama.cpp, vLLM y stable‑diffusion.cpp. Cualquiera puede comprobar qué ocurre con una petición, desde la API hasta la GPU.
Ejemplos
Cómo funciona
Tres configuraciones, paso a paso: una workstation compartida, una transcripción de reuniones en una tarjeta de 16 GB y una redacción que resume, ilustra y lee artículos en voz alta. Las cifras proceden de las recetas de giq.
- gemma-4-12bLLMmantener cargado9,5 GB
- whisper-large-v3Voz → textomantener cargado4,0 GB
- ecapa-tdnnHuella de vozmantener cargado0,6 GB
- vacía
01/09Tres recetas mantenidas en memoria
gemma‑4‑12b para chat, whisper‑large‑v3 para transcripción, ecapa‑tdnn para huellas de voz. 14,1 de 31,8 GB en uso.
Elija una configuración o avance paso a paso con los controles.
¿Necesidades similares?
Si ejecuta varios modelos para varias aplicaciones en su propio hardware y no caben todos a la vez en la tarjeta, giq puede ahorrarle construir esto por su cuenta.
Requisitos: Linux, una GPU NVIDIA, Python 3.11+ con uv y llama.cpp para LLMs. Los detalles están en el README.
Reglamento de IA de la UE
¿Opera en la UE? Hablemos del cumplimiento del Reglamento de IA para su aplicación.
Lo que el Reglamento de IA le exige depende de cada aplicación: su finalidad, sus usuarios y si sus resultados salen de la empresa. giq ya marca las imágenes generadas como generadas por IA y registra cada trabajo sin guardar su contenido. Junto con usted determinamos qué medidas técnicas necesita su aplicación. info@vik.works
Nos ocupamos de las medidas técnicas: marcado, registro y documentación. La evaluación jurídica de su aplicación corresponde a su asesoría jurídica.
giq lo desarrollan vik.works UG (haftungsbeschränkt) y otros colaboradores.
Las imágenes de fondo de esta página se generaron con giq, con la receta zimage.
Los nombres de productos y modelos son marcas de sus respectivos titulares; giq no está afiliado a ellos ni cuenta con su respaldo.